
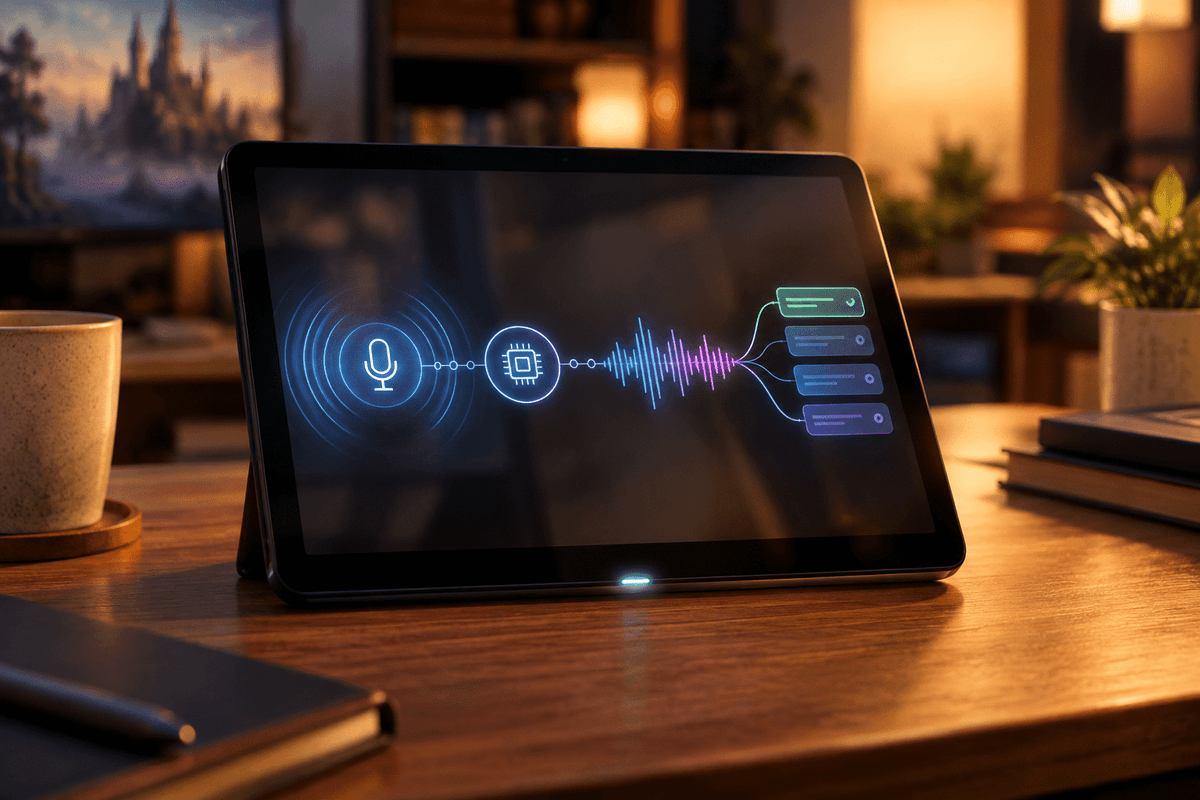
Un mot fait apparaître un rocher. Un autre déplace une plate-forme. Ce qui retient mon attention dans Mina and the Spirit of Words, ce n’est pas la promesse de parler à un jeu : c’est le choix de reconnaître ces commandes directement sur la machine, sans envoyer la voix à un service distant. Pour une action qui doit s’inscrire entre deux déplacements à la manette, cette décision compte davantage qu’une étiquette « intelligence artificielle ».
Présenté à l’Osaka Indie Games Summit 2026, ce jeu d’action-aventure en 3D de Latent Entertainment porte le titre japonais ミナと言霊の物語. Son développeur, yoshi, conserve les commandes classiques pour déplacer le personnage et réserve la voix à la manipulation de l’environnement. Le prototype propose ainsi une répartition concrète des tâches : les mains assurent la navigation, les mots transforment le terrain.
Cette séparation mérite une analyse technique, sans lui attribuer des capacités qu’elle n’a pas démontrées. La reconnaissance locale est au cœur du projet. En revanche, aucun chiffre de latence ni aucune mécanique détaillée de durée d’incantation ne permettent encore de juger la précision temporelle des sorts. Il faut distinguer ce que le système exécute, ce que son architecture permet et ce qui reste à établir.
| Élément | Caractéristique | Conséquence pratique |
|---|---|---|
| Projet | Mina and the Spirit of Words, par Latent Entertainment et yoshi | Un jeu individuel centré sur l’interaction vocale avec le décor |
| Genre | Action-aventure 3D à un joueur | La voix accompagne une progression spatiale |
| Contrôles | Manette pour les déplacements, microphone pour les commandes vocales | La parole ne remplace pas tous les boutons |
| Reconnaissance | Traitement entièrement local | Aucun service cloud nécessaire pour reconnaître les commandes |
| Sort « Rock » | Apparition d’un rocher utilisable comme appui | Création d’un élément de progression |
| Sort « Eleve » | Mise en mouvement d’une plate-forme | Activation directe d’un mécanisme du niveau |
| Matériel audio | Fonctionnement présenté avec un microphone intégré à un ordinateur portable courant | Pas d’accessoire spécialisé exigé par le concept |
| Plateformes | Projet PC ; compatibilité technique avec les smartphones également travaillée | Une sortie commerciale sur smartphone n’est pas confirmée |
| Disponibilité | Prix, date de sortie et configuration minimale non précisés | Impossible d’évaluer aujourd’hui le rapport qualité-prix |
La donnée décisive n’est donc pas une puissance de calcul annoncée, mais l’emplacement du traitement. Tout se joue sur l’appareil. L’autre information importante est l’usage d’un microphone ordinaire : le projet n’impose pas, dans son principe, un périphérique propriétaire. Cela ne garantit toutefois ni une reconnaissance identique sur tous les ordinateurs ni une tolérance universelle au bruit.
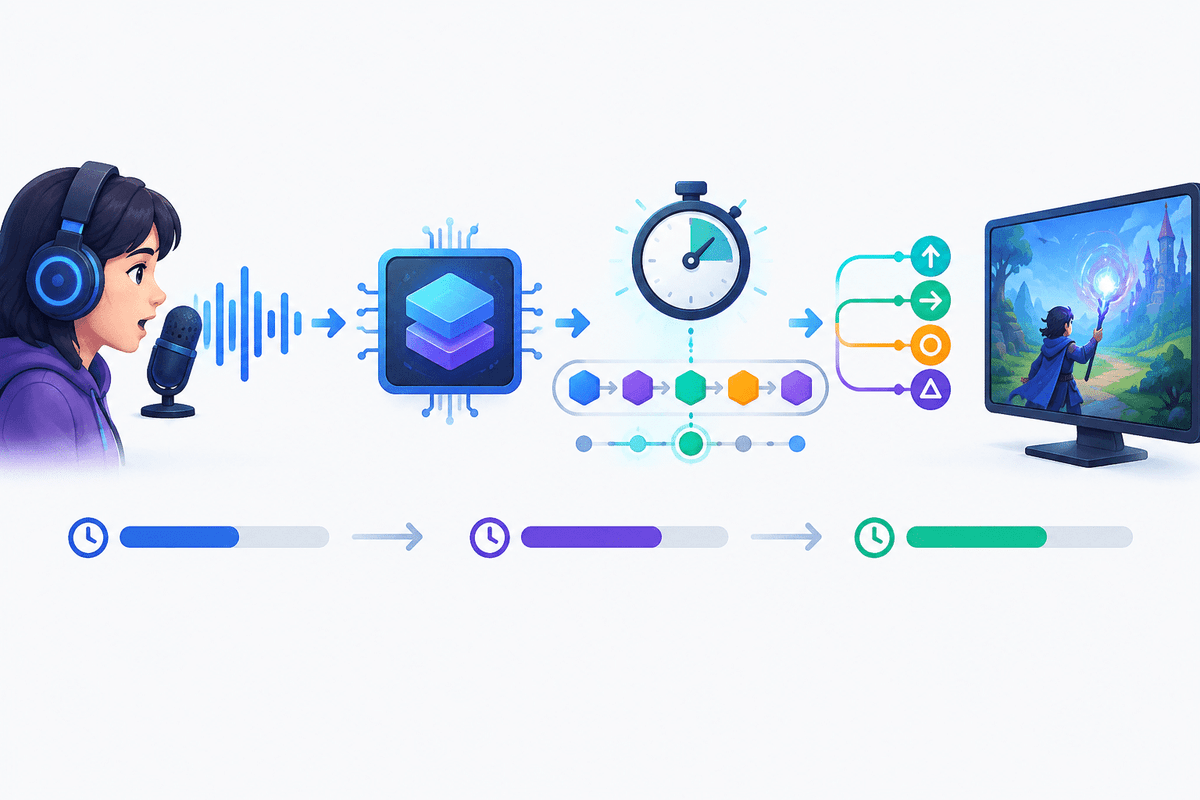
Le fonctionnement visible suit une séquence simple. Le microphone capte le mot prononcé, le moteur de reconnaissance identifie une commande, puis le jeu lui associe une action. Avec « Rock », un rocher apparaît et peut servir d’appui. Avec « Eleve », une plate-forme se déplace. Le résultat attendu est spatial : il change les possibilités de déplacement, pas seulement le contenu d’une boîte de dialogue.
Il serait trompeur de décrire cela comme un personnage qui comprend librement le joueur. Les exemples du prototype reposent sur des mots-clés. Rien ne permet d’attribuer au système une compréhension de phrases complexes, de demandes improvisées ou d’intentions implicites. La liste complète du vocabulaire, les variantes de prononciation acceptées et les possibilités de personnalisation ne sont pas précisées.
Ce périmètre limité n’est pas un défaut en soi. Un jeu d’action a besoin d’ordres prévisibles. Une commande associée à un effet identifiable peut être plus utile qu’un interprète généraliste hésitant entre plusieurs intentions. La qualité du système dépend alors de sa capacité à reconnaître les mots prévus et à les déclencher au bon moment. Le spectaculaire vient du décor qui change, pas de la longueur du vocabulaire.
Reconnaître la voix localement évite l’envoi de l’audio vers un serveur chargé de l’interpréter. Pour cette fonction, le jeu n’a donc pas besoin d’une liaison cloud. C’est un choix pertinent : une variation de connexion ne doit pas décider du moment où un appui apparaît sous les pieds du personnage. L’architecture retire du circuit le trajet réseau et la dépendance à un service distant.
Elle ne rend pas la commande instantanée. La capture sonore prend du temps, le système doit identifier le mot, puis le jeu doit exécuter l’action et afficher son résultat. Selon les techniques employées, déterminer que la prononciation est terminée peut aussi représenter une partie du délai. Le moteur de Mina ne publie pas sa méthode sur ce point ; il serait abusif de lui attribuer un fonctionnement précis.
Aucune latence chiffrée en millisecondes n’est disponible pour le prototype. « Local » décrit donc une architecture, pas une mesure de réactivité. Cela signifie également que la machine assume le calcul et les données nécessaires à la reconnaissance. L’empreinte mémoire, le coût processeur et la taille du moteur ne sont pas précisés. On ne peut pas conclure qu’ils sont négligeables simplement parce que les commandes sont courtes.
Le bénéfice de confidentialité doit être formulé avec la même précision. Reconnaître les sorts ne nécessite pas de transmettre l’audio à un prestataire cloud. Cela ne constitue pas une description complète de toutes les pratiques de données du futur jeu. De même, l’absence de cloud pour la voix ne garantit pas que la distribution, une activation éventuelle ou d’autres fonctions seront entièrement utilisables hors ligne.
Le vocabulaire magique entretient une ambiguïté. Le « temps d’incantation » peut désigner la durée pendant laquelle le joueur parle, le délai nécessaire pour reconnaître son mot ou une durée volontairement imposée par les règles du jeu. Ces notions ont des conséquences différentes. Dans le prototype présenté, aucun paramètre chiffré appelé « chant time » ne permet de les relier à une mécanique précise.
| Notion | Ce qu’elle désigne | État pour Mina |
|---|---|---|
| Durée de prononciation | Le temps pris par le joueur pour dire le mot | Aucune durée minimale ou maximale précisée |
| Délai de reconnaissance | Le temps nécessaire pour identifier la commande | Aucune mesure de latence publiée |
| Temps de préparation du sort | Une attente volontaire prévue par le gameplay | Aucune règle détaillée confirmée |
| Charge vocale | Une durée de parole qui modifierait le résultat | Aucun effet confirmé sur la puissance, la portée ou la durée |
Il n’est donc pas établi qu’allonger « Rock » produise un rocher plus grand, qu’une répétition charge le sort ou qu’une voix plus forte augmente son efficacité. La démo montre l’identification d’un mot et l’action correspondante. L’intonation, le volume et la longueur de l’incantation ne doivent pas devenir des fonctionnalités imaginaires sous prétexte que le thème les rend plausibles.
Cette distinction détermine pourtant la conception des niveaux. Un délai constant peut devenir une contrainte que le joueur apprend à anticiper. Un délai variable est plus problématique si un saut exige l’apparition précise d’un appui. Pour Mina, ce sont des critères d’évaluation, pas des défauts mesurés. Sans chronométrage ni description des fenêtres d’activation, impossible de décider si le timing constitue une difficulté volontaire ou une limite technique.
Yoshi a commencé à développer des jeux environ deux ans avant cette présentation et a consacré approximativement six mois à construire son moteur de reconnaissance vocale. Ce travail personnel est notable, mais « moteur maison » n’est pas un certificat de supériorité. L’intérêt tient à la possibilité de concevoir la reconnaissance autour des besoins du jeu, plutôt que d’adapter le gameplay à un service généraliste.
Le revers est une responsabilité technique considérable. Le moteur doit fonctionner avec les systèmes audio des appareils, distinguer les commandes et rester utilisable pendant que le jeu affiche sa scène 3D. Le nom du modèle, ses données, ses bibliothèques éventuelles et son architecture acoustique ne sont pas publics. Il ne faut donc pas présenter cette reconnaissance comme un grand modèle de langage, ni lui attribuer une technique particulière.
La compatibilité locale entre PC et smartphones a constitué une difficulté importante du développement. Cela se comprend : les contraintes de ressources et les systèmes de capture audio diffèrent selon les appareils. Mais un travail de portabilité n’équivaut pas à une annonce commerciale. La fiche du projet concerne le PC ; elle ne fournit ni calendrier de sortie mobile ni liste d’appareils pris en charge.
Le fonctionnement avec le petit microphone d’un ordinateur portable courant est un détail plus intéressant qu’une promesse vague de compatibilité. Il indique que le projet ne repose pas sur un accessoire de studio. C’est important pour un jeu indépendant : imposer un achat supplémentaire avant même de commencer créerait une barrière disproportionnée. Un casque-micro fait également partie des usages envisagés, sans spécification matérielle détaillée.
Il faut néanmoins éviter de transformer cet exemple en garantie. Aucun modèle précis, seuil sonore ou résultat comparatif ne permet de classer les microphones. Dans une installation domestique, la distance à la bouche, les haut-parleurs et les conversations environnantes peuvent modifier le signal capté. Ce sont des contraintes générales de reconnaissance vocale, pas des problèmes dont on aurait mesuré l’ampleur dans Mina.
Le conseil pratique est de commencer avec le matériel déjà disponible, avant d’acheter un micro pour ce seul jeu. Sélectionner la bonne entrée audio, vérifier qu’elle n’est pas coupée et réduire les sons parasites seront des vérifications utiles. Elles ne remplacent pas une calibration intégrée. La prise en charge de périphériques Bluetooth précis ou de microphones incorporés à des manettes reste également à déterminer.
Une invocation réussie ne suffit pas à juger une interface. Le moment révélateur survient lorsque rien ne se passe. Le joueur doit pouvoir comprendre si le mot n’a pas été reconnu, si le sort est indisponible ou si l’environnement interdit son effet. Ce sont trois situations différentes. La démo ne détaille pas la manière dont le jeu les distingue ni les informations qu’il fournit après un échec.
Un retour visuel ou sonore clairement associé à la reconnaissance serait utile pour séparer la réception de l’ordre de son exécution. Cette recommandation ne suppose pas une transcription permanente à l’écran. Un indicateur discret peut suffire, à condition d’être lisible pendant le déplacement. L’essentiel est que le joueur ne soit pas obligé de répéter plus fort sans savoir ce qui a bloqué.
Les activations accidentelles méritent la même attention. Le prototype ne précise pas l’existence d’un bouton d’écoute, d’un mot d’éveil ou d’une fenêtre limitant les commandes acceptées. Il ne décrit pas non plus les règles de répétition et d’annulation. Dans un jeu où une parole modifie le décor, ces protections ne sont pas de simples réglages audio : elles font partie des règles d’interaction.
Hey You, Pikachu!, sur Nintendo 64, exploitait déjà un dispositif de reconnaissance vocale pour interagir avec un personnage. Plus tard, le microphone intégré de la Nintendo DS a rendu les interactions sonores accessibles sans accessoire séparé. Dans The Legend of Zelda: Phantom Hourglass, souffler dans le microphone participait ainsi à certaines énigmes. Ces précédents rappellent que la voix et le souffle sont depuis longtemps des entrées de jeu.
Ces exemples ne sont pas technologiquement équivalents. Détecter un souffle n’est pas reconnaître un mot, et un système de commandes limitées n’est pas une conversation libre. Le parallèle utile porte sur le design : demander au joueur une action inhabituelle ne suffit pas. Cette action doit produire un résultat compréhensible et justifier les contraintes qu’elle ajoute à l’usage quotidien.
Mina trouve ici un argument cohérent. Dire un mot pour matérialiser un appui correspond à sa fiction magique et transforme directement l’espace. Garder la manette pour les mouvements évite aussi d’imposer la parole à chaque correction de trajectoire. Ce partage des contrôles m’intéresse davantage qu’une tentative de tout remplacer par la voix. Il réserve le geste inhabituel aux actions qui lui donnent du sens.
Les mots montrés, « Rock » et « Eleve », ne constituent pas une politique linguistique complète. Les langues prises en charge, les accents acceptés et les variantes de prononciation ne sont pas indiqués. Pour une commande vocale, une aide écrite ne suffit pas toujours : il faut que le joueur sache quelle forme sonore le moteur attend, sans devoir deviner la prononciation retenue.
Les joueurs qui ne peuvent pas parler, qui fatiguent rapidement leur voix ou qui jouent dans une pièce partagée ont des besoins différents. Une commande alternative à la manette permettrait de préserver l’accès aux énigmes tout en laissant l’expérience vocale disponible. Une telle solution n’est pas confirmée. C’est un point de conception important, même si la parole constitue l’identité du projet.
Le contexte social compte également. Prononcer régulièrement des sorts n’est pas aussi discret qu’appuyer sur un bouton. Jouer la nuit, diffuser une partie ou discuter simultanément avec des proches peut rendre cette interaction moins pratique. Le traitement local résout la dépendance au serveur ; il ne supprime ni le besoin de parler ni les contraintes que cela impose au lieu de jeu.
Mina intéressera d’abord les amateurs d’exploration et d’énigmes spatiales qui apprécient une interface inhabituelle. Créer un rocher ou mettre une plate-forme en mouvement offre un lien immédiat entre parole et transformation du niveau. Pour ce public, une incantation peut enrichir l’action au lieu de simplement ajouter une étape entre l’intention et son résultat.
Les joueurs attachés à des contrôles strictement reproductibles devront attendre des informations sur la réactivité et les possibilités de remplacement. Aucun taux de reconnaissance, de faux déclenchement ou de réussite selon le microphone ne permet encore une recommandation technique ferme. Une éventuelle démo publique serait le bon terrain pour vérifier son propre usage, mais sa disponibilité n’est pas annoncée ici.
Je ne conseillerais pas d’acheter du matériel audio en prévision de cette sortie. Le prix du jeu, sa date, sa boutique et ses exigences ne sont pas précisés. Les informations décisives avant un achat seront plus modestes qu’une grande annonce sur l’IA : vocabulaire des sorts, configuration requise, comportement après une erreur, commandes alternatives et règles exactes du timing.
Le bilan doit rester celui d’un prototype. Les choix d’architecture sont identifiables ; la fiabilité à long terme ne l’est pas encore. Voici ce qui mérite d’être retenu sans transformer une intention de conception en résultat mesuré.
Ce qui m’intéresse dans Mina and the Spirit of Words est son usage ciblé de la reconnaissance vocale. La voix transforme l’environnement, tandis que la manette conserve les mouvements. Le traitement local retire une dépendance inutile pour ces commandes et évite de lier leur interprétation à la disponibilité d’un serveur. Ce sont de bons choix de départ.
La suite se jouera dans des détails moins spectaculaires : reconnaître correctement le mot, signaler un échec et déclencher l’action dans un délai suffisamment prévisible. Aucun effet de charge lié à la durée de prononciation n’est confirmé. Le potentiel du projet est réel, mais son intérêt durable dépendra de la confiance que le joueur pourra accorder à chaque incantation.
Accédez à des stratégies exclusives, des astuces cachées et des analyses pro que nous ne partageons pas publiquement.
Guide stratégique ultime Tech + Astuces pro hebdomadaires