
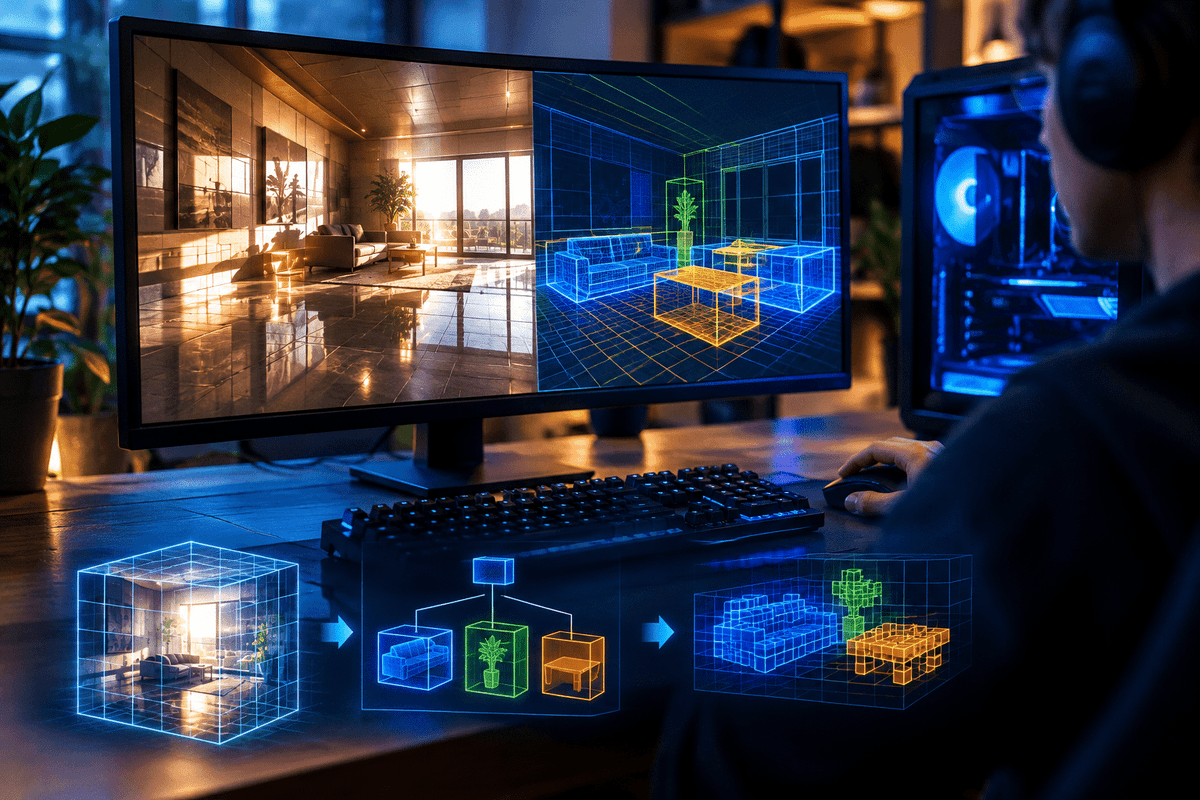
À 60 images par seconde, le budget de rendu est de 16,7 millisecondes par image. Le ray tracing doit y faire tenir davantage que le calcul des reflets ou des ombres : il faut aussi préparer les structures qui permettent aux rayons de trouver rapidement la géométrie. Dans une scène très détaillée qui se transforme continuellement, cette préparation peut devenir un poste de dépense important.
C’est ce travail préalable que Microsoft attaque avec l’Agility SDK 1.722.0-preview, annoncé le 28 octobre 2026. Clustered Geometry, les Partitioned Top-Level Acceleration Structures — PTLAS — et les constructions indirectes interviennent à des niveaux complémentaires. Leur logique commune : réutiliser les données encore valides et concentrer les opérations sur ce qui change.
| Élément | Fonction | Conséquence pratique |
|---|---|---|
| Agility SDK 1.722.0-preview | Expose les nouvelles fonctions DXR en préversion | Permet leur intégration expérimentale dans les moteurs Windows |
| Agility SDK 1.620 retail | Branche stable publiée parallèlement | À distinguer de la préversion qui apporte ces fonctions ray tracing |
| Clustered Geometry | Découpe la géométrie en petits groupes de triangles réutilisables | Affine la construction et la réutilisation sous le niveau habituel de l’objet |
| PTLAS | Partitionne la structure d’accélération de niveau supérieur | Concentre les mises à jour sur les partitions modifiées |
| Constructions indirectes | Consomment des entrées de construction depuis la mémoire GPU | Réduisent la préparation CPU lorsque le moteur produit déjà ces données sur le GPU |
Le point décisif n’est donc pas une nouvelle manière de simuler la lumière. Ces fonctions optimisent l’organisation et l’entretien des données utilisées par DXR. Elles prennent surtout leur sens dans les scènes dynamiques où une reconstruction trop large gaspille du temps de calcul.
Une BVH, pour Bounding Volume Hierarchy, organise la géométrie dans une hiérarchie de volumes englobants. Un rayon peut éliminer rapidement des régions entières de la scène au lieu de tester chaque triangle. Cette accélération est indispensable, mais la hiérarchie doit rester cohérente avec les objets affichés.
Dans le fonctionnement classique de DirectX Raytracing, les BLAS décrivent la géométrie au niveau inférieur. Le TLAS organise les instances de ces structures dans la scène, notamment leurs transformations. Déplacer un objet rigide et déformer son maillage ne touchent donc pas nécessairement les mêmes données.
Depuis l’introduction de DXR en 2018, construire puis entretenir ces accélérateurs fait partie du coût du ray tracing. Les chemins classiques savent déjà effectuer certaines mises à jour : présenter la nouveauté comme la fin d’une reconstruction systématique de toute la scène serait trompeur. Le changement porte sur une granularité plus fine, la réutilisation et le pilotage depuis le GPU.
Microsoft décrit cette évolution comme la plus importante de DXR depuis son introduction. L’enjeu technique justifie l’attention : à mesure que les décors gagnent en détail et en mobilité, accélérer uniquement le parcours des rayons ne suffit plus. Il faut aussi contenir le travail qui prépare ce parcours.
Clustered Geometry découpe les maillages en petits groupes de triangles pouvant être construits et réutilisés indépendamment. Le moteur dispose ainsi d’unités plus fines qu’un objet traité comme un bloc unique. Lorsque seule une partie de la géométrie change, les groupes restés valides peuvent être conservés.
L’intérêt est concret pour les objets déformables et les décors très détaillés. Une modification locale n’a pas à entraîner le même travail qu’un changement généralisé du maillage. La réutilisation peut également limiter certaines duplications de données ou de structures intermédiaires.
Ce découpage n’est toutefois pas gratuit. Le moteur doit constituer les clusters, suivre leur validité et décider quand les reconstruire ou les réutiliser. Des unités trop grosses réduisent la finesse de l’optimisation ; des unités trop petites multiplient les éléments à gérer. Le bon compromis dépend de la géométrie et de son comportement, pas seulement du nombre total de triangles.
PTLAS intervient au-dessus, dans l’organisation des instances. Au lieu de gérer uniquement une structure globale, le moteur peut répartir la scène en partitions spatiales ou logiques. Les partitions inchangées restent en place ; les opérations se concentrent sur celles qui nécessitent une mise à jour.
Imaginez une grande carte dont une seule zone accueille une foule en mouvement. Le bénéfice recherché consiste à traiter cette activité sans imposer un travail comparable aux régions immobiles. À l’inverse, si presque toutes les partitions changent à chaque image, l’avantage peut fortement diminuer.
PTLAS conserve la prise en charge des BLAS existants. Il n’impose donc pas de convertir simultanément toute la géométrie en clusters. Clustered Geometry et PTLAS peuvent fonctionner séparément ou ensemble : le premier affine la gestion des triangles, le second celle des instances dans la scène.
La qualité du partitionnement devient une décision de moteur importante. Une partition trop vaste entraîne du travail inutile lors d’une petite modification. Une multiplication excessive des partitions ajoute des métadonnées, de la gestion et potentiellement des synchronisations. Les déplacements d’instances entre régions doivent aussi rester cohérents avec ce découpage.
La troisième brique concerne l’alimentation des constructions d’accélérateurs. Les Indirect Acceleration-Structure Builds permettent de consommer des paramètres présents en mémoire GPU, plutôt que de faire préparer systématiquement les descriptions correspondantes par le CPU.
Cela convient aux moteurs où des shaders de calcul produisent déjà des instances, des transformations ou de la géométrie. Les données générées sur le GPU peuvent alimenter la construction des accélérateurs sans détour systématique par une préparation CPU. Un moteur qui conserve ses listes d’instances principalement côté processeur bénéficie moins directement de cette organisation.
Il faut distinguer les gains : réduire la préparation CPU ne réduit pas automatiquement le travail GPU dans les mêmes proportions. Les dépendances entre animation, génération de géométrie, construction des BVH et lancement des rayons restent à gérer.
Ces mécanismes ouvrent des possibilités d’économie mémoire, mais le bilan doit compter davantage que la taille finale des accélérateurs. Les buffers temporaires de construction, les métadonnées des partitions et les éventuelles duplications de clusters occupent eux aussi de la VRAM. Réutiliser davantage peut coûter moins cher ; cela ne garantit pas que toute scène consommera moins de mémoire.
Un comparatif utile doit d’abord séparer les chemins de construction. Sinon, impossible de savoir si le résultat provient du partitionnement, de la géométrie en clusters ou simplement d’un changement de stratégie de mise à jour.
| Chemin testé | Ce qu’il permet d’isoler | Scène à examiner |
|---|---|---|
| TLAS classique avec reconstruction complète | Coût de référence d’une reconstruction globale | Scène largement renouvelée |
| TLAS classique avec mise à jour | Bénéfice déjà accessible sans PTLAS | Instances modifiées dans une structure réutilisable |
| PTLAS avec BLAS classiques | Apport propre du partitionnement | Changements concentrés dans quelques régions |
| PTLAS avec Clustered Geometry | Apport combiné des partitions et des clusters | Scène détaillée avec changements d’instances et de géométrie |
Pour chaque chemin, il faut relever le temps GPU de construction initiale, celui des mises à jour, la mémoire allouée et temporaire, ainsi que le nombre de partitions touchées et de clusters reconstruits. Le temps CPU doit être mesuré séparément pour apprécier les constructions indirectes.
Le test doit aussi conserver une scène statique de référence et provoquer des changements de portée différente : une modification locale, puis une modification traversant de nombreuses partitions. Des scènes de destruction, de végétation animée ou de chargement progressif d’instances exposent mieux ces compromis qu’un simple déplacement de caméra dans un décor immobile.
Enfin, le temps d’image complet reste l’arbitre. Une construction BVH plus rapide peut être en partie absorbée par des attentes entre calcul, rastérisation et ray tracing. Les résultats doivent donc préciser le GPU, le pilote, le runtime Agility SDK et les réglages de construction, tout en montrant les pics de temps d’image plutôt qu’une seule moyenne en images par seconde.
Pour expérimenter ces fonctions, les développeurs doivent utiliser les en-têtes et le runtime correspondants de l’Agility SDK 1.722.0-preview, disposer d’un pilote compatible et activer le mode développeur de Windows pour les fonctionnalités expérimentales concernées. Le statut de préversion signifie que l’API, les exigences de pilote et les performances peuvent encore évoluer.
Les moteurs chargés de scènes très détaillées et fortement dynamiques sont les premiers concernés. Ceux qui préparent déjà leurs données sur le GPU ont aussi une raison précise d’évaluer les constructions indirectes. Pour une scène presque statique, le chemin BLAS/TLAS classique reste une référence indispensable avant d’accepter cette complexité supplémentaire.
Côté joueur, ce SDK n’est ni un réglage graphique ni une mise à niveau automatique des jeux existants. Le moteur doit intégrer les nouvelles fonctions. Cette préversion ne constitue donc pas, à elle seule, une raison de remplacer sa carte graphique. La décision d’achat doit attendre des résultats dans les jeux et les charges réellement visés, pas se fonder sur le seul nom d’une nouvelle API.
Accédez à des stratégies exclusives, des astuces cachées et des analyses pro que nous ne partageons pas publiquement.
Guide stratégique ultime Tech + Astuces pro hebdomadaires